REST API 응답 설계: 고객사가 쓰기 편한 JSON
API를 만들 때는 기능 구현에 시간을 많이 쓰지만, 정작 고객사가 만나는 것은 응답 JSON 한 덩어리입니다. 고객사 개발자는 이 JSON을 보고 "이 API 쓸 만하네" 혹은 "연동하기 까다롭네"를 판단합니다.
같은 데이터를 주더라도 응답을 어떻게 설계했느냐에 따라 연동에 걸리는 시간과 이후 문의 건수가 크게 달라집니다.
특히 연동 이후가 중요합니다.
필드 이름이 제각각이면 매핑 코드가 늘어나고, 페이징 방식이 불분명하면 데이터가 빠지거나 중복되고, 예고 없이 응답이 바뀌면 고객사 서비스가 멈춥니다. 이런 문제는 대부분 처음 설계할 때 몇 가지 원칙만 정해 두면 피할 수 있습니다.
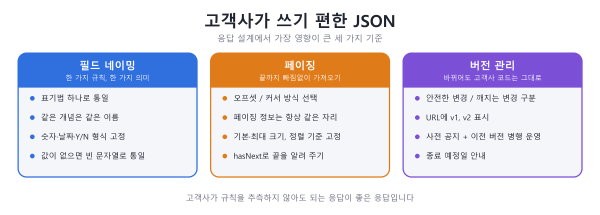
이 글에서는 응답 JSON을 설계할 때 가장 영향이 큰 세 가지, 필드 네이밍, 페이징, 버전 관리를 중심으로 고객사가 쓰기 편한 응답의 기준을 정리했습니다.
1. 필드 네이밍: 한 가지 규칙, 한 가지 의미
필드 이름은 응답에서 가장 먼저 읽히는 부분이자, 고객사 코드에 그대로 박히는 부분입니다. 한번 공개한 이름은 바꾸기 어렵기 때문에 처음부터 규칙을 정해 두는 것이 좋습니다.
표기법은 하나로 통일
productName, product_name, ProductName처럼 표기법이 섞이면 고객사는 필드마다 이름을 외워야 합니다. camelCase든 snake_case든 상관없지만, 모든 엔드포인트에서 하나만 써야 합니다. 보통 JSON을 주로 소비하는 곳이 자바스크립트라면 camelCase, 파이썬이나 데이터 분석 쪽이라면 snake_case를 많이 씁니다. 고객사 환경에 맞춰 고르되, 고른 뒤에는 예외를 두지 않는 것이 핵심입니다.
같은 개념은 같은 이름으로
주문 목록에서는 customerId, 주문 상세에서는 userId, 결제 응답에서는 buyerId로 같은 사람을 가리키는 경우가 의외로 많습니다. 내부 시스템이 각자 발전해 온 흔적이 그대로 노출된 것이죠. 고객사 입장에서는 이 셋이 같은 값인지 문서를 뒤져 확인해야 합니다. 응답을 설계할 때는 개념 하나에 이름 하나를 정하고, 내부 테이블 이름이나 컬럼명을 그대로 노출하지 않도록 한 번 걸러 주세요.
값의 타입과 형식을 고정
이름만큼 중요한 것이 값의 모양입니다.
• 숫자는 숫자로: 가격은 3000이지 "3,000원"이 아닙니다. 단위가 필요하면 currency: "KRW"처럼 별도 필드로 줍니다.
• 날짜는 `yyyyMMdd` 한 가지로: 20261027처럼 구분 기호 없는 8자리로 통일합니다. 국내 공공 API와 금융·세무 연동에서 가장 흔히 쓰는 형식이라 고객사가 익숙하고, 문자열 그대로 정렬·비교할 수 있습니다. 시각까지 필요하면 20261027131500(yyyyMMddHHmmss)처럼 같은 방식으로 이어 붙이고, 어느 필드가 날짜이고 어느 필드가 시각인지 이름과 문서에 분명히 적어 둡니다. 핵심은 형식 자체보다 모든 응답에서 한 가지 형식만 쓰는 것입니다. 어떤 필드는 20261027, 어떤 필드는 2026-10-27, 어떤 필드는 2026.10.27로 오면 고객사는 필드마다 변환 코드를 만들어야 합니다.
• 참/거짓은 `"Y"`/`"N"` 한 가지로: 어떤 필드는 "Y", 어떤 필드는 1, 어떤 필드는 true로 오면 고객사는 필드마다 해석 방식을 달리해야 합니다. 국내 연동에서는 "Y"/"N"을 가장 흔히 쓰고, 연동 엔진이나 고객사 시스템에 따라 true/false를 그대로 받기 어려운 경우도 있습니다. 어느 쪽을 쓰든 하나만 정해서 모든 응답에 똑같이 적용하세요.
• 코드값은 문서화된 고정 값으로: status가 "ACTIVE", "CLOSED"처럼 정해진 값만 오도록 하고, 가능한 값 목록을 문서에 적어 둡니다.
• 큰 숫자와 ID는 문자열로 고려: 자바스크립트는 아주 큰 정수를 정확히 표현하지 못합니다. 아래 두 번째 ID 예시처럼 19자리 같은 큰 ID는 문자열로 주는 편이 안전합니다.
값이 없을 때의 표현도 하나로
값이 없는 경우를 어떤 필드는 null, 어떤 필드는 "", 어떤 필드는 "-", 어떤 필드는 아예 생략하면 고객사는 경우마다 따로 처리해야 합니다. 필드는 항상 존재하고, 값이 없으면 빈 문자열 `""`로 통일하는 방식이 가장 단순합니다. 응답에 어떤 필드가 있는지 항상 같고, 값의 타입도 늘 문자열이라 고객사 코드가 단순해집니다. 특히 null은 연동 엔진이나 고객사 시스템에 따라 받지 못하거나 "null"이라는 글자로 바뀌어 저장되는 경우가 있어, 처음부터 ""로 맞춰 두는 편이 안전합니다. "-"처럼 사람이 읽기 위한 대체 문자는 데이터와 구분이 안 되므로 쓰지 않는 것이 좋습니다.
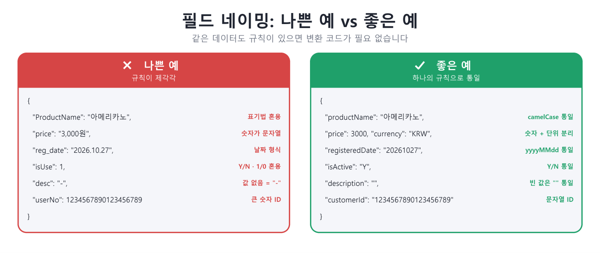
하나의 응답에서 보는 나쁜 예와 좋은 예
// 나쁜 예
{
"ProductName": "아메리카노",
"price": "3,000원",
"reg_date": "2026.10.27",
"isUse": 1,
"desc": "-",
"userNo": 1234567890123456789
}
// 좋은 예
{
"productName": "아메리카노",
"price": 3000,
"currency": "KRW",
"registeredDate": "20261027",
"isActive": "Y",
"description": "",
"customerId": "1234567890123456789"
}
표기법, 타입, 날짜 형식, 값없음 표현이 모두 한 가지 규칙으로 정리되었습니다. 고객사가 이 응답을 자기 시스템의 데이터 구조로 옮길 때 별도의 변환 코드가 거의 필요 없습니다.
응답의 겉모양도 일정하게
목록이든 단건이든, 성공이든 실패든 응답의 뼈대가 일정해야 합니다. 특히 초보자가 자주 부딪히는 함정이 결과 개수에 따라 구조가 바뀌는 경우입니다. 결과가 여러 개일 때는 배열로 오다가, 1개일 때는 배열이 아닌 객체 하나로, 0개일 때는 빈 문자열이나 다른 값으로 오면 고객사 코드는 개수마다 분기해야 합니다. 목록 응답은 0개든 1개든 100개든 항상 배열로 주세요.
2. 페이징: 끝까지 빠짐없이 가져올 수 있게
데이터가 많은 API는 결과를 나눠서 줍니다. 한 번에 수만 건을 주면 서버도 고객사도 힘들기 때문입니다. 이때 중요한 것은 고객사가 첫 페이지부터 마지막 페이지까지 빠짐없이, 중복 없이 가져올 수 있느냐입니다.
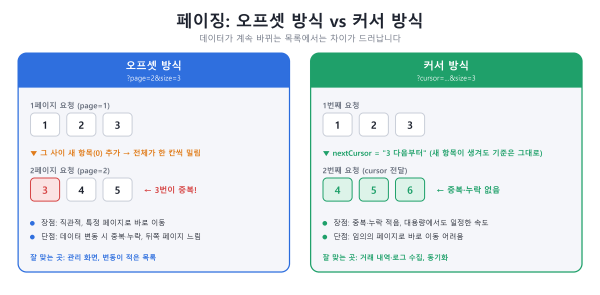
대표적인 두 가지 방식
오프셋(페이지 번호) 방식은 page=3&size=50이나 offset=100&limit=50처럼 몇 번째부터 몇 개를 달라고 요청하는 방식입니다. 직관적이고 "3페이지로 바로 이동" 같은 기능을 만들기 쉽습니다. 하지만 조회하는 동안 새 데이터가 들어오거나 삭제되면 페이지 경계가 밀려 같은 항목이 두 번 나오거나 어떤 항목은 건너뛰게 됩니다. 또한 뒤쪽 페이지로 갈수록 서버가 앞의 데이터를 모두 건너뛰어야 해서 느려질 수 있습니다.
커서 방식은 "이 항목 다음부터 50개"처럼 마지막으로 받은 위치를 기준으로 요청하는 방식입니다. 데이터가 계속 추가되는 목록에서도 중복과 누락이 거의 없고, 뒤쪽 페이지에서도 속도가 일정합니다. 대신 임의의 페이지로 바로 이동하기는 어렵습니다.
구분 | 오프셋 방식 | 커서 방식 |
요청 예시 | ?page=3&size=50 | ?cursor=abc123&size=50 |
장점 | 직관적, 특정 페이지로 이동 가능 | 중복·누락 적음, 대용량에서도 빠름 |
단점 | 데이터 변동 시 중복·누락, 뒤쪽 페이지 느림 | 특정 페이지로 바로 이동 어려움 |
잘 맞는 경우 | 관리 화면, 데이터가 거의 안 바뀌는 목록 | 거래 내역·로그처럼 계속 쌓이는 대용량 데이터 |
데이터를 시스템 간에 수집·동기화하는 용도라면 커서 방식이 안전한 선택입니다. 사람이 화면에서 페이지를 넘겨보는 용도라면 오프셋 방식으로도 충분합니다.
페이징 정보는 항상 같은 이름, 같은 자리에
어떤 방식을 쓰든 페이징 정보를 응답의 같은 위치에 담아야 합니다. 목록 데이터와 페이징 정보를 분리해서 주면 고객사가 반복 호출 코드를 한 번만 만들어 두고 모든 목록 API에 재사용할 수 있습니다.
{
"data": [
{ "orderId": "ORD-0001", "amount": 12000 },
{ "orderId": "ORD-0002", "amount": 8500 }
],
"paging": {
"size": 2,
"totalCount": 135,
"hasNext": "Y",
"nextCursor": "eyJpZCI6Ik9SRC0wMDAyIn0"
}
}
• data: 결과 목록입니다. 0건이어도 빈 배열 []로 줍니다.
• hasNext: 다음 페이지가 있는지 알려 줍니다. 고객사는 이 값이 "N"이 될 때까지 반복하면 됩니다.
• nextCursor: 다음 요청에 그대로 넣을 값입니다. 고객사가 값의 의미를 해석할 필요가 없도록 불투명한 문자열로 줍니다. 내부 구조를 노출하지 않으니 나중에 내부 구현을 바꿔도 고객사 코드는 영향을 받지 않습니다.
• totalCount: 전체 건수입니다. 건수가 아주 많은 데이터에서 매번 정확히 세는 비용이 크다면 생략하거나 별도 옵션으로 제공해도 됩니다.
다음 페이지 주소를 응답에 통째로 넣어 주는 방식("next": "https://api.example.com/orders?cursor=...")도 널리 쓰입니다. 고객사가 URL을 조립할 필요가 없어 실수가 줄어듭니다. 어느 쪽이든 핵심은 고객사가 규칙을 추측하지 않아도 되게 하는 것입니다.
페이징에서 자주 놓치는 것들
• 기본 크기와 최대 크기를 정해 두세요. size를 생략했을 때의 기본값과, 요청할 수 있는 최댓값(예: 100)을 문서에 적고, 최댓값을 넘기면 조용히 잘라 주기보다 오류로 알려 주는 편이 오해가 적습니다.
• 정렬 기준을 고정하세요. 정렬이 명시되지 않으면 같은 요청도 호출할 때마다 순서가 바뀔 수 있습니다. 정렬 기준이 같은 값(예: 같은 시각)을 가질 수 있다면 ID 같은 고유 값을 보조 기준으로 함께 쓰세요. 그래야 경계에서 항목이 흔들리지 않습니다.
• 마지막 페이지의 모습을 정해 두세요. 마지막 페이지에서 hasNext: "N"과 nextCursor: ""가 오는지, 범위를 벗어난 페이지를 요청하면 빈 목록이 오는지 오류가 오는지 일관되게 정해야 합니다.
3. 버전 관리: 바뀌어도 고객사 코드는 그대로
API는 한 번 만들고 끝나지 않습니다. 새 기능이 붙고, 잘못 설계한 필드를 고치고, 정책이 바뀝니다. 문제는 그 변화가 이미 연동한 고객사의 코드를 깨뜨릴 때입니다. 고객사는 우리 일정에 맞춰 코드를 고치지 않습니다. 예고 없이 응답이 바뀌면 고객사 서비스가 멈추고, 그 순간 API의 신뢰는 크게 떨어집니다.
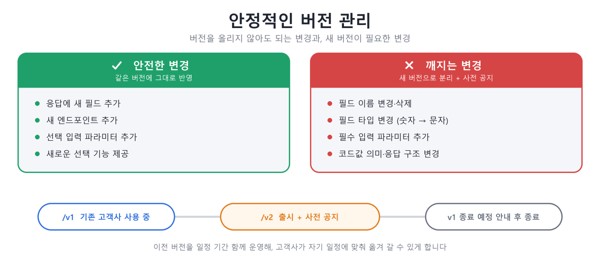
안전한 변경과 깨지는 변경
먼저 변경을 두 종류로 구분해 두면 판단이 쉬워집니다.
안전한 변경 (버전을 올리지 않아도 됨) | 깨지는 변경 (새 버전이 필요함) |
응답에 새 필드 추가 | 필드 이름 변경 또는 삭제 |
새 엔드포인트 추가 | 필드의 타입 변경 (숫자 → 문자열) |
선택 입력 파라미터 추가 | 필수 입력 파라미터 추가 |
새로운 선택 기능 제공 | 코드값의 의미 변경, 응답 구조(중첩) 변경 |
이 기준이 통하려면 고객사도 약속을 지켜야 합니다. 응답에 모르는 필드가 와도 무시하도록 코드를 짜는 것입니다. 그래서 제공하는 쪽은 문서에 "새 필드는 예고 없이 추가될 수 있으니 알 수 없는 필드는 무시해 주세요"라고 미리 적어 두는 것이 좋습니다. 또한 코드값(status 등)에 새 값이 추가될 수도 있으므로, 알 수 없는 값이 오면 어떻게 처리하면 되는지도 함께 안내하면 더 좋습니다.
버전은 어디에 표시할까
버전을 표시하는 방식은 크게 세 가지입니다.
방식 | 예시 | 특징 |
URL 경로 | /v1/orders, /v2/orders | 눈에 잘 보이고 테스트·공유가 쉬워 가장 널리 쓰임 |
요청 헤더 | API-Version: 2026-10-01 | URL이 깔끔하지만 브라우저 주소창 등에서 확인이 어려움 |
쿼리 파라미터 | /orders?version=2 | 간단하지만 누락되기 쉬움 |
고객사에게 제공하는 API라면 URL 경로 방식을 권합니다. 어떤 버전을 쓰는지 로그와 문서, 문의 내용에서 한눈에 드러나기 때문에 운영과 지원이 쉬워집니다. 버전 단위는 v1, v2처럼 큰 단위로 관리하세요. 작은 수정마다 버전을 올리면 운영해야 할 버전이 끝없이 늘어납니다.
버전을 올릴 때의 절차
깨지는 변경이 불가피하다면 다음 순서를 지켜 주세요.
1. 미리 공지: 변경 내용, 새 버전 주소, 종료 일정을 충분히 일찍 알립니다. 고객사의 개발 일정은 우리와 다릅니다.
2. 병행 운영: 새 버전을 내놓더라도 이전 버전을 일정 기간 함께 운영합니다. 고객사가 자기 일정에 맞춰 옮겨 갈 수 있게 해야 합니다.
3. 이전 버전 응답에도 안내: 종료 예정인 버전의 응답에는 종료 예정일을 알려 주는 정보를 담습니다. HTTP 헤더에는 Deprecation(곧 사용 중단), Sunset(종료 시점) 같은 표준 헤더가 있어서 프로그램이 자동으로 감지하게 만들 수 있습니다.
4. 마이그레이션 가이드 제공: 이전 버전과 새 버전의 차이를 항목별로 비교한 표와 예시를 준비합니다.
5. 변경 이력 공개: 날짜별로 무엇이 추가되고 바뀌었는지 변경 이력(changelog)을 문서에 남깁니다.
응답에서의 오류 형식도 약속의 일부
버전 관리와 함께 챙겨야 할 것이 오류 응답입니다. 성공 응답이 잘 설계되어 있어도 실패했을 때 응답이 제각각이면 고객사는 오류 처리 코드를 엔드포인트마다 따로 만들어야 합니다. 실패했는데 HTTP 상태 코드는 200으로 보내고 본문에만 "error"를 적는 것도 피해야 합니다. 프로그램이 오류 메시지를 정상 데이터로 착각해 저장할 수 있기 때문입니다.
HTTP 상태 코드를 정확히 쓰고(잘못된 요청은 400, 인증 실패는 401, 권한 없음은 403, 없는 자원은 404, 호출 한도 초과는 429, 서버 문제는 5xx), 본문에는 프로그램이 구분할 수 있는 오류 코드와 사람이 읽을 수 있는 설명을 함께 담습니다. 이런 오류 응답의 구조를 정한 국제 표준(RFC 9457)도 있으니 참고할 만합니다.
{
"type": "https://api.example.com/errors/invalid-parameter",
"title": "요청 값이 올바르지 않습니다.",
"status": 400,
"detail": "size는 1 이상 100 이하의 정수여야 합니다.",
"errors": [
{ "field": "size", "message": "최댓값(100)을 초과했습니다." }
]
}
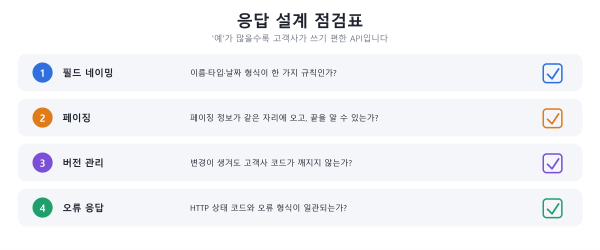
응답을 설계할 때 확인할 점검표
지금까지의 내용을 설계 단계에서 바로 쓸 수 있는 체크리스트로 정리했습니다.
필드 네이밍
• 모든 엔드포인트에서 하나의 표기법(camelCase 또는 snake_case)을 쓰는가
• 같은 개념에 같은 이름을 쓰고, 내부 컬럼명을 그대로 노출하지 않는가
• 숫자는 숫자로, 날짜는 yyyyMMdd 한 가지로, 참/거짓은 "Y"/"N" 한 가지로 주는가
• 값이 없을 때의 표현이 빈 문자열 "" 하나로 통일되어 있는가
• 목록은 결과가 0개든 1개든 항상 배열로 오는가
페이징
• 데이터 성격에 맞는 방식(오프셋 또는 커서)을 골랐는가
• 페이징 정보가 모든 목록 API에서 같은 이름, 같은 자리에 오는가
• 기본 크기, 최대 크기, 정렬 기준, 마지막 페이지의 모습이 정해져 있는가
버전 관리
• 안전한 변경과 깨지는 변경의 기준이 팀 안에서 합의되어 있는가
• 버전이 URL 등 눈에 띄는 곳에 표시되는가
• 공지, 병행 운영, 종료 예정 안내, 마이그레이션 가이드, 변경 이력의 절차가 있는가
• 오류 응답이 표준 형식으로 일관되며, HTTP 상태 코드와 일치하는가
마무리: 좋은 응답은 '예측할 수 있는' 응답
세 가지를 한 문장으로 줄이면, 고객사가 쓰기 편한 JSON은 예측할 수 있는 JSON입니다. 필드 이름과 값의 모양을 예측할 수 있고, 데이터가 많아도 끝까지 가져올 수 있다는 것을 예측할 수 있고, 앞으로 API가 바뀌어도 내 코드가 안전하다는 것을 예측할 수 있는 응답입니다.
이런 응답은 처음 설계할 때 조금만 더 신경 쓰면 만들 수 있지만, 한번 공개한 뒤에 고치려면 고객사의 코드 수정이라는 비용이 따릅니다. 그래서 API는 기능을 만드는 일만큼, 약속을 만드는 일이라고 생각해야 합니다. 그 약속이 잘 지켜질수록 고객사는 연동에 드는 시간을 줄이고, 우리는 문의 대응에 드는 시간을 줄일 수 있습니다.
출처
• IETF, RFC 9457: Problem Details for HTTP APIs (2023) — https://datatracker.ietf.org/doc/html/rfc9457
• IETF, RFC 8594: The Sunset HTTP Header Field (2019) — https://datatracker.ietf.org/doc/html/rfc8594
• IETF, RFC 9745: The Deprecation HTTP Response Header Field (2025) — https://datatracker.ietf.org/doc/html/rfc9745
• Microsoft, REST API Guidelines (Pagination, Versioning) — https://github.com/microsoft/api-guidelines
• Google Cloud, API Design Guide (Standard fields, Pagination) — https://cloud.google.com/apis/design